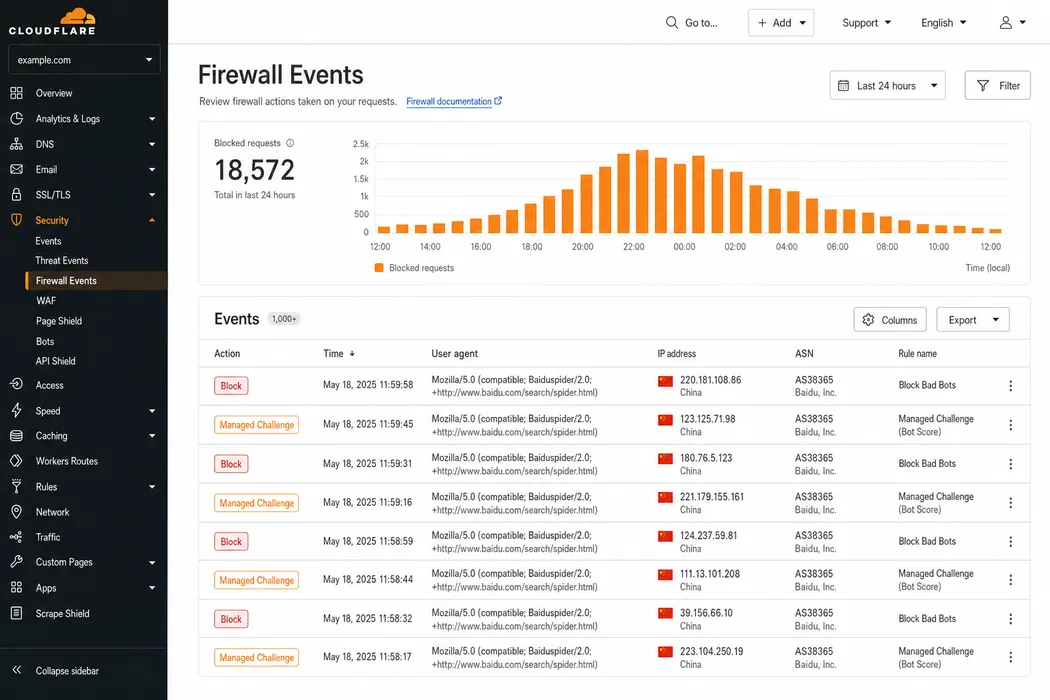
Rien dans une stack de supervision normale ne guette ce phénomène. Les contrôles de disponibilité partent de Francfort et de Virginie, et le suivi des utilisateurs réels ne voit que ceux qui ont déjà obtenu une page. Pendant ce temps, le seul visiteur qui compte se fait refouler à la périphérie, et cela n’apparaît que sur un tableau de bord que personne n’a ouvert.
Nous le rencontrons plus souvent que toute autre cause technique de lancement chinois enlisé, bien avant quoi que ce soit dans la construction WordPress elle-même, et il s’agit presque toujours d’un réglage dont personne ne se souvient.
Pourquoi vos règles par défaut attrapent le robot de Baidu
Baiduspider atteint votre origine depuis des réseaux de Chine continentale. Le DNS inverse sur les adresses légitimes du robot se résout en *.baidu.com ou *.baidu.jp, l’essentiel des récupérations venant des plages continentales.
Songez maintenant à ce qu’une posture de sécurité standard fait de ces plages. On y trouve généralement une règle géographique qui défie ou bloque la Chine, ajoutée pendant un incident et jamais réexaminée, plus un réglage de gestion des bots qui note comme suspect tout client automatisé inconnu. Sous les deux repose un jeu de règles managé, calibré sur du trafic occidental. Aucune de ces règles n’a été écrite en pensant à un robot de recherche chinois. Baiduspider ressemble à du trafic automatisé venu d’une région à laquelle vous avez décidé de ne pas faire confiance, et il récolte donc ce que vous avez configuré pour elle.
Rien de tout cela ne déclenche d’alerte. Un robot bloqué n’ouvre pas de ticket. Il réessaie, obtient la même réponse, et revient moins souvent.
En septembre 2026, Baidu pesait 46,65 % du marché des moteurs de recherche en Chine, toutes plateformes confondues, et 60,15 % sur mobile, selon Statcounter. Source : Statcounter Global Stats, septembre 2026. https://gs.statcounter.com/search-engine-market-share/all/china et https://gs.statcounter.com/search-engine-market-share/mobile/china
Ce marché se trouve de l’autre côté de la règle.
Le cas qui n’a jamais été résolu
Un fil de la communauté Cloudflare mérite une lecture. Un propriétaire de site avait placé le fichier de vérification Baidu, baidu_verify_codeva-CODE.html, à la racine du document. Il se résolvait publiquement, et n’importe qui hors de Chine pouvait le récupérer avec un 200. Le contrôle de Baidu signalait un timeout d’entrée-sortie. Le fil s’est refermé sans solution.
Ce cas ne prouve pas que Cloudflare bloque Baidu par principe. Il montre quelque chose de plus étroit : un fichier accessible depuis votre bureau ne prouve rien quant à la capacité de Baidu à l’atteindre, et les deux réalités peuvent diverger des semaines durant pendant que tout le monde fixe une URL qui fonctionne.
La vérification par fichier de Baidu est étroite. Le fichier se trouve à la racine du document et renvoie un 200, sans redirection ni authentification. La méthode par balise HTML n’est pas plus indulgente, puisque la balise meta doit apparaître dans le HTML livré par le serveur. Une page intermédiaire casse les deux.
Un 403 est le bon scénario
Quand la périphérie refuse Baiduspider franchement, vous récoltez un 403, et c’est le scénario à espérer. Un refus est un fait que les deux parties peuvent constater.
La version coûteuse est le défi. Une page intermédiaire en JavaScript renvoie un 200, vos journaux d’accès enregistrent une requête servie, et le robot reçoit une page de script à la place de votre contenu. Tous vos tableaux de bord affirment que la requête a réussi, et côté Baidu il y a une récupération vide.
La limitation de débit forme le troisième motif, et le plus pénible à déboguer. Le robot passe le mardi et pas le mercredi, et aucune règle identifiable n’explique pourquoi.
Le DNS inverse est le seul contrôle qui tienne
Autoriser l’agent utilisateur est le bon point de départ et le mauvais point d’arrivée. Les chaînes légitimes sont Baiduspider/2.0 et Baiduspider-render/2.0, les variantes mobiles portant Android ou Mobile. La variante render prend les gens de court. Elle récupère ce dont une page a besoin pour s’afficher, si bien qu’une règle autorisant Baiduspider/2.0 et limitant le reste laisse entrer le robot puis l’affame.
Un agent utilisateur est un en-tête de requête, et un en-tête de requête est une chaîne que n’importe qui peut taper. Autorisez sur cette seule base et vous ouvrez votre WAF à quiconque a lu un billet de blog.
Le contrôle qui tient est une résolution inverse confirmée dans les deux sens. Prenez l’IP du client, résolvez l’enregistrement PTR avec host ou dig, vérifiez que le nom d’hôte se termine par baidu.com ou baidu.jp, puis résolvez ce nom d’hôte dans l’autre sens et contrôlez que vous retombez sur la même adresse. Un enregistrement PTR seul ne prouve rien, puisqu’il est défini par celui qui contrôle le bloc d’adresses.
Construisez la règle dans cet ordre : correspondance de l’agent utilisateur, confirmation par DNS inverse, puis autorisation. Certaines plateformes de périphérie le font pour les robots connus. Là où la vôtre ne le fait pas, un court script de worker suffit.
Baidu décrit lui-même ces deux résolutions dans ses consignes, avec une mise en garde sur les listes d’adresses IP.
Un nom d’hôte Baiduspider authentique se termine par .baidu.com ou .baidu.jp ; tout autre nom relève de l’usurpation. La résolution directe de ce nom doit renvoyer l’IP d’origine. Baidu dit ne pas pouvoir publier les plages d’adresses de son robot, qui varient sans cesse. Source : Baidu Search Resource Platform (百度搜索资源平台), février 2022. https://ziyuan.baidu.com/college/articleinfo?id=3378
Des blogs SEO chinois diffusent toujours des listes de plages IP attribuées à Baiduspider. Une liste d’autorisation tirée de l’une d’elles fige des adresses dont Baidu prévient lui-même qu’elles changeront. Authentifiez le robot par DNS inverse, systématiquement, et jamais sur la foi de l’agent utilisateur.
Ce que quatre extensions WordPress font aux robots chinois
Sur un site WordPress, une fois la requête admise par la périphérie, un second jeu de règles entre en scène. Il se niche dans les extensions de sécurité et de cache, et nous n’y avons trouvé qu’une seule exemption pour les robots, au bénéfice de Google.
Nous avons épluché le code source de quatre extensions le 4 septembre 2026, puis à nouveau le 9 octobre 2026 sur leurs dernières versions. Chez deux d’entre elles, il suffit de modifier un réglage pour refouler les robots chinois. LiteSpeed Cache et W3 Total Cache ne contiennent rien de tel.
| Extension | Version lue | Configuration d’origine | Ce qui peut refouler les robots chinois |
|---|---|---|---|
| Wordfence | 9.0.0, identique en 9.0.2 | Cinq limitations de débit, toutes désactivées. Une seule règle pour les robots, réservée à Google | Un nombre saisi dans « If a crawler’s page views exceed » |
| Solid Security, devenu Kadence Security | 10.0.3, identique en 10.0.5 | « Default Ban List » désactivée | Une fois activée, elle écrit dans la configuration du serveur un 403 visant 360Spider, EasouSpider et YisouSpider |
| LiteSpeed Cache | 7.9.1 | « Do Not Cache User Agents » vide | Rien dans le code |
| W3 Total Cache | 2.10.6, identique en 2.10.7 | Listes d’agents utilisateurs rejetés vides | Rien dans le code |
Les extensions de cache sont donc mises hors de cause. Leurs listes d’agents utilisateurs servent seulement à désigner les visiteurs qui échappent au cache, et toutes deux arrivent vides. Si Baiduspider reçoit un 403 sur un site équipé de l’une ou l’autre, il faut chercher la cause ailleurs dans la pile.
LiteSpeed Cache 7.9.1 est livré avec « Do Not Cache User Agents » vide. W3 Total Cache 2.10.6 livre vides ses listes d’agents utilisateurs rejetés pour le cache de pages, la minification et le CDN, et la 2.10.7 n’y change rien. Aucune règle visant nommément Baiduspider ne figure dans le code de l’une ou l’autre. Source : code source de LiteSpeed Cache 7.9.1 et de W3 Total Cache 2.10.6, WordPress.org, lu les 4 septembre et 9 octobre 2026. https://wordpress.org/plugins/litespeed-cache/ et https://wordpress.org/plugins/w3-total-cache/
Wordfence 9.0.0 réserve à Google sa seule règle pour les robots
Dans Wordfence, les cinq limitations de débit sont désactivées d’origine : toutes les requêtes, les pages vues par les robots, les 404 des robots, les pages vues par les humains et les 404 des humains. L’interrupteur général, « Enable Rate Limiting and Advanced Blocking », reste quant à lui actif, si bien qu’une limite s’applique dès qu’on y saisit un nombre.
Les robots d’indexation n’ont droit qu’à un seul réglage, « How should we treat Google’s crawlers ». Par défaut, il exempte de toute limitation de débit les robots Google authentifiés. Wordfence les vérifie à partir des plages IP de Google, puis par une résolution inverse qui doit aboutir à googlebot.com ou à un autre nom d’hôte de Google, confirmée par une résolution directe. Rien d’équivalent pour Baidu, ni pour aucun autre moteur de recherche.
Saisissez un nombre dans « If a crawler’s page views exceed », dans la rubrique Rate Limiting Rules du pare-feu, et Googlebot passe sans être compté, tandis que Baiduspider est décompté comme n’importe quel robot. Une fois la limite franchie, il reçoit un 503, que l’action reste sur le ralentissement ou passe au blocage. Wordfence consigne le ralentissement. Baidu, lui, ne reçoit qu’une erreur serveur, et l’on retrouve le scénario décrit plus haut : le robot passe le mardi et se fait refouler le mercredi.
Le réflexe serait d’autoriser Baiduspider. Mais la liste d’autorisation de Wordfence, « Allowlisted IP addresses that bypass all rules », n’accepte que des adresses et des plages IP (l’extension n’offre aucune liste d’autorisation par agent utilisateur), et Baidu, on l’a vu plus haut, ne publie pas ses plages.
Wordfence 9.0.0 est livré avec ses cinq limitations de débit réglées sur DISABLED. Son unique réglage consacré aux robots, « How should we treat Google’s crawlers », a pour valeur par défaut « Verified Google crawlers will not be rate-limited ». Sa liste d’autorisation n’accepte que des adresses et des plages IP. Wordfence 9.0.2, la version en vigueur, est identique. Source : code source de Wordfence 9.0.0 (publiée le 10 août 2026), lu les 4 septembre et 9 octobre 2026, et de la 9.0.2, lu le 9 octobre 2026. https://wordpress.org/plugins/wordfence/
Laissez désactivées les limites de Wordfence applicables aux robots, ou fixez-les très au-dessus de ce qu’envoie un passage d’indexation. S’il faut brider les robots, faites-le au niveau du CDN ou du WAF placé devant le site, où une règle peut procéder à la vérification par DNS inverse avant de se mettre à compter.
La liste de bannissement de Solid Security refoule 360 Search et Shenma
Solid Security est distribué sous l’identifiant better-wp-security et porte, depuis la version 10.0.0 de mai 2026, le nom de Kadence Security. Son module Ban Users comprend un réglage baptisé « Default Ban List », désactivé à l’installation. Sa description le présente comme un point de départ.
Activez-le, et l’extension inscrit la liste de bannissement HackRepair.com dans la configuration de votre serveur : .htaccess sous Apache et LiteSpeed, nginx.conf sous nginx. Cette liste répond par un 403 à tout agent utilisateur contenant 360Spider ou YisouSpider, ainsi qu’à une troisième chaîne, EasouSpider. 360Spider explore le Web pour le compte de 360 Search (360搜索), YisouSpider pour celui de Shenma Search (神马搜索).
Baiduspider ne figure pas sur la liste.
Solid Security 10.0.3 est livré avec « Default Ban List » à la valeur “default”: false. Une fois activée, la liste HackRepair.com est inscrite dans la configuration du serveur et renvoie un 403 aux agents utilisateurs correspondant à 360Spider, EasouSpider et YisouSpider. Kadence Security 10.0.5, la version en vigueur, contient la même liste. Source : code source de Solid Security 10.0.3 (publiée le 27 juillet 2026), lu les 4 septembre et 9 octobre 2026, et de la 10.0.5, lu le 9 octobre 2026. https://wordpress.org/plugins/better-wp-security/
La règle se trouve dans la configuration du serveur : WordPress ne voit donc jamais la requête, et rien n’en garde trace dans les journaux de l’extension. Si quelqu’un l’a activée à la mise en route du site, celui-ci refoule 360 Search et Shenma depuis lors.
L’agent utilisateur du robot de Shenma Search est yisouspider. Source : plateforme pour webmasters de Shenma Search (神马搜索), juillet 2014. https://zhanzhang.sm.cn/open/optimizaGuide
Désactivez la Default Ban List, puis ouvrez .htaccess ou nginx.conf et vérifiez que le bloc commençant par « # Start HackRepair.com Blacklist » a disparu. Pour rouvrir la porte à 360 Search par adresse, la démarche s’inverse par rapport à Baidu. 360 publie les plages IP de son robot et précise que la résolution inverse ne fonctionne pas encore pour lui : c’est donc par une liste d’autorisation IP qu’il demande à être admis.
Le robot de 360 Search porte 360Spider dans son agent utilisateur. 360 publie les plages IP de son robot sur la même page et indique que la vérification par nslookup n’est pas encore prise en charge. Source : 360 Search (360搜索), page d’aide 360蜘蛛IP, février 2026. https://www.so.com/help/spider_ip.html
Faites dire à Baidu ce qu’il a reçu
Le diagnostic de crawl (抓取诊断) de la Baidu Search Resource Platform (百度搜索资源平台) récupère une URL en se présentant comme Baiduspider et vous montre la réponse. Agent desktop ou mobile, au choix. Il renvoie les 200 premiers Ko du corps, de quoi révéler une page intermédiaire ou une page d’erreur.
Nous le sortons avant de toucher à quoi que ce soit d’autre, parce qu’il met fin aux discussions. Lancez-le sur la page d’accueil, sur le fichier de vérification et sur trois pages profondes. Les règles de périphérie sont souvent cantonnées à des chemins précis, et la page d’accueil est en général le seul chemin que quelqu’un a exempté.
Le quota est de 70 récupérations par semaine et par site : l’outil ne se prête donc pas à un test de charge. Lisez aussi le corps renvoyé, car un 200 ne dit rien de son contenu.
Le diagnostic de crawl autorise 70 récupérations par semaine et par site, et affiche les 200 premiers Ko du contenu que voit Baiduspider. Source : Baidu Search Resource Platform (百度搜索资源平台), page de l’outil de diagnostic de crawl, consultée le 9 octobre 2026. https://ziyuan.baidu.com/crawltools/index
L’hébergement à l’étranger aggrave chacun de ces cas
Héberger hors de Chine continentale ne bloque rien en soi. Cela ajoute de la latence et de la perte de paquets par-dessus ce que vos règles font déjà.
Ajoutez un aller-retour supplémentaire pour un défi sur une connexion limite et elle cesse d’être limite. Un timeout d’entrée-sortie ressemble exactement à cela vu de l’extérieur : la page se charge vite depuis l’Europe pendant que Baidu enregistre une connexion qui a renoncé. L’hébergement continental supprime la variable, au prix d’un dépôt ICP (ICP备案).
L’ordre dans lequel modifier les choses
Commencez par vos journaux. Filtrez la périphérie sur les agents utilisateurs Baiduspider des 30 derniers jours. Zéro requête signifie que le robot ne vous atteint pas du tout. S’il y a des requêtes, la question devient ce que vous avez renvoyé.
Retirez ensuite les instruments contondants dans l’ordre. Les règles géographiques visant la Chine partent en premier, ou se réduisent aux chemins qui en ont réellement besoin. Les exceptions de gestion des bots pour un Baiduspider authentifié viennent ensuite, puis les exceptions sur le jeu de règles managé, une fois que vous savez quelle règle s’est déclenchée. Les limitations de débit en dernier, parce que ce sont les défaillances les plus difficiles à attribuer.
Sur un site WordPress, on passe ensuite à l’origine. Désactivez la Default Ban List de Solid Security si elle est active, et vérifiez que personne n’a fixé de limite aux robots dans Wordfence.
Contrôlez robots.txt tant que vous y êtes. Le testeur de Baidu plafonne le fichier à 48 Ko, et un disallow égaré recopié depuis la préproduction a coûté plus de lancements chinois que n’importe quelle règle de pare-feu.
L’outil robots de Baidu analyse au plus 48 Ko d’un fichier robots.txt. Source : Baidu Search Resource Platform (百度搜索资源平台), page de l’outil robots, consultée le 9 octobre 2026. https://ziyuan.baidu.com/robots/index
Une fois les règles retirées, relancez le diagnostic de crawl, en commençant par le fichier de vérification, l’URL qui retient tout le reste. La vérification aboutit dans un délai allant de l’instantané à 24 heures dès que le robot peut la lire. Le volume d’index est plus lent : zéro pendant des jours ou des semaines même quand tout est correct, l’indexation initiale demandant couramment deux à quatre semaines. Modifiez une chose à la fois, sinon le zéro suivant ne vous apprendra rien.
Relancez le diagnostic de crawl après chaque mise à jour du WAF ou du CDN, car les réglages par défaut de la périphérie changent selon leur propre calendrier.
Envie d'un coup de main ?
ChinaWebFoundry pilote vos projets WordPress en Chine de bout en bout. Si l'ampleur du chantier vous intimide, écrivez-nous.
En parler