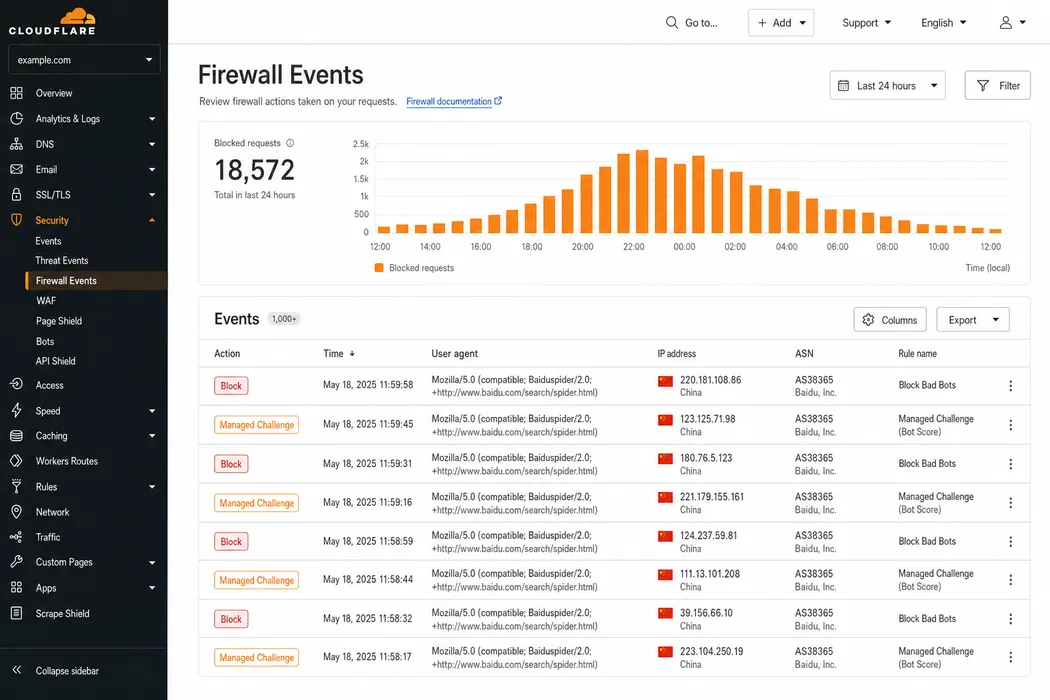
Nada en una pila de monitorización normal está vigilando esto. Las comprobaciones de disponibilidad se lanzan desde Fráncfort y Virginia, y la monitorización de usuarios reales solo ve a quienes ya han conseguido una página. Mientras tanto, al único visitante que importa lo están echando en el borde de la red, y eso solo aparece en un panel que nadie ha abierto.
Lo vemos con más frecuencia que cualquier otra causa técnica de un lanzamiento chino encallado, muy por delante de cualquier cosa que ocurra en la propia construcción del sitio WordPress, y casi siempre se trata de un ajuste que nadie recuerda haber hecho.
Por qué sus reglas por defecto atrapan al rastreador de Baidu
Baiduspider llega a su origen desde redes de China continental. El DNS inverso sobre las direcciones legítimas del rastreador resuelve a *.baidu.com o *.baidu.jp, y son los rangos continentales los que hacen la mayor parte de las peticiones.
Piense ahora en lo que una postura de seguridad estándar hace con esos rangos. Suele haber una regla geográfica que desafía o bloquea a China, añadida durante un incidente y nunca revisada, más un ajuste de gestión de bots que puntúa como sospechoso a cualquier cliente automatizado desconocido. Debajo de ambos descansa un conjunto de reglas gestionado y calibrado sobre tráfico occidental. Ninguna de esas reglas se escribió pensando en un rastreador de búsqueda chino. Baiduspider parece tráfico automatizado procedente de una región de la que usted decidió desconfiar, así que recibe lo que usted configuró para ella.
Nada de esto genera una alerta. Un rastreador bloqueado no abre una incidencia. Reintenta, obtiene la misma respuesta y vuelve con menos frecuencia.
En septiembre de 2026, Baidu acaparaba el 46,65 % del mercado de buscadores en China, sumadas todas las plataformas, y el 60,15 % en el móvil, según Statcounter. Fuente: Statcounter Global Stats, septiembre de 2026. https://gs.statcounter.com/search-engine-market-share/all/china y https://gs.statcounter.com/search-engine-market-share/mobile/china
Ese mercado está al otro lado de la regla.
El caso que nunca se resolvió
Hay un hilo de la comunidad de Cloudflare que merece una lectura. El propietario de un sitio había colocado el archivo de verificación de Baidu, baidu_verify_codeva-CÓDIGO.html, en la raíz del documento. Se resolvía públicamente y cualquiera fuera de China podía recuperarlo y obtener un 200. La comprobación de Baidu informaba de un tiempo de espera agotado de entrada y salida. El hilo se cerró sin solución.
Ese caso no demuestra que Cloudflare bloquee a Baidu por política. Muestra algo más concreto: un archivo accesible desde su escritorio no demuestra nada sobre si Baidu puede alcanzarlo, y ambas realidades pueden contradecirse durante semanas mientras todo el mundo mira fijamente una URL que funciona.
La verificación por archivo de Baidu es estrecha. El archivo se sitúa en la raíz del documento y devuelve un 200, sin redirección y sin autenticación. El método de la etiqueta HTML no es más indulgente, porque la etiqueta meta tiene que aparecer en el HTML que entrega el servidor. Una página intersticial rompe las dos.
Un 403 es el buen desenlace
Cuando el borde rechaza a Baiduspider sin rodeos, usted obtiene un 403, que es el desenlace que conviene esperar. Un rechazo es un hecho que ambas partes pueden ver.
La versión cara es el desafío. Un intersticial de JavaScript devuelve un 200, sus registros de acceso anotan una petición servida y el rastreador recibe una página de script donde debería estar su contenido. Todos sus paneles afirman que la petición tuvo éxito, y en el lado de Baidu hay una recuperación vacía.
La limitación de peticiones es el tercer patrón y el peor de depurar. El rastreador pasa el martes y no pasa el miércoles, y ninguna regla concreta explica por qué.
El DNS inverso es la única comprobación que aguanta
Permitir el agente de usuario es el punto de partida correcto y el punto de llegada equivocado. Las cadenas legítimas son Baiduspider/2.0 y Baiduspider-render/2.0, con variantes móviles que llevan Android o Mobile. La variante render pilla desprevenida a mucha gente: recupera lo que una página necesita para renderizarse, de modo que una regla que permite Baiduspider/2.0 y limita el resto deja entrar al rastreador y después lo mata de hambre.
Un agente de usuario es una cabecera de petición, y una cabecera de petición es una cadena que cualquiera puede escribir. Si permite solo con eso, ha abierto su WAF a cualquiera que haya leído una entrada de blog.
La comprobación que aguanta es una resolución inversa confirmada en ambos sentidos. Tome la IP del cliente, resuelva el registro PTR con host o dig, confirme que el nombre de host termina en baidu.com o baidu.jp, y resuelva después ese nombre de host en sentido directo para comprobar que vuelve a darle la misma dirección. Un registro PTR por sí solo no demuestra nada, porque lo fija quien controla el bloque de direcciones.
Construya la regla en ese orden: coincidencia del agente de usuario, confirmación por DNS inverso y después permiso. Algunas plataformas de borde ya lo hacen con los rastreadores conocidos. Donde la suya no lo haga, basta con un script de worker breve.
El propio Baidu describe esas dos consultas en sus directrices, y añade una advertencia sobre las listas de direcciones IP.
Un nombre de host auténtico de Baiduspider termina en .baidu.com o .baidu.jp, y cualquier otro delata una suplantación. La resolución directa de ese nombre debe devolver la IP original. Baidu afirma que no puede publicar los rangos de IP de su rastreador porque varían constantemente. Fuente: Baidu Search Resource Platform (百度搜索资源平台), febrero de 2022. https://ziyuan.baidu.com/college/articleinfo?id=3378
Algunos blogs chinos de SEO siguen publicando listas de rangos de IP de Baiduspider. Una lista blanca elaborada con cualquiera de ellas congela unas direcciones que, como advierte el propio Baidu, cambiarán. Verifique el rastreador por DNS inverso en cada ocasión, nunca por el agente de usuario.
Lo que hacen cuatro plugins de WordPress con los rastreadores chinos
En un sitio WordPress, un segundo conjunto de reglas entra en juego cuando el borde ya ha dejado pasar la petición. Reside en los plugins de seguridad y de caché, y la única exención para rastreadores que hemos encontrado en ellos beneficia a Google.
Leímos el código fuente de cuatro plugins el 4 de septiembre de 2026 y volvimos a hacerlo el 9 de octubre de 2026 con las versiones vigentes. En dos de ellos basta con tocar un solo ajuste para que los rastreadores chinos queden fuera. En LiteSpeed Cache y W3 Total Cache no hay nada parecido.
| Plugin | Versión leída | Configuración de serie | Qué puede rechazar a los rastreadores chinos |
|---|---|---|---|
| Wordfence | 9.0.0, sin cambios en 9.0.2 | Los cinco límites de peticiones, desactivados. Una única regla para rastreadores, reservada a Google | Un número escrito en «If a crawler’s page views exceed» |
| Solid Security, hoy Kadence Security | 10.0.3, sin cambios en 10.0.5 | «Default Ban List» desactivada | Al activarla, escribe en la configuración del servidor un 403 para 360Spider, EasouSpider y YisouSpider |
| LiteSpeed Cache | 7.9.1 | «Do Not Cache User Agents» vacía | Nada en el código |
| W3 Total Cache | 2.10.6, sin cambios en 2.10.7 | Listas de agentes de usuario rechazados vacías | Nada en el código |
Los plugins de caché quedan, por tanto, descartados. Sus listas de agentes de usuario solo determinan qué visitantes se saltan la caché, y en los dos vienen vacías. Si Baiduspider recibe un 403 en un sitio que usa cualquiera de ellos, hay que buscar la causa en otra parte de la pila.
LiteSpeed Cache 7.9.1 viene con «Do Not Cache User Agents» vacía. W3 Total Cache 2.10.6 trae vacías sus listas de agentes de usuario rechazados para la caché de páginas, la minificación y el CDN, y la 2.10.7 es igual. Ninguno de los dos incluye en su código una regla que mencione a Baiduspider. Fuente: código fuente de LiteSpeed Cache 7.9.1 y W3 Total Cache 2.10.6, WordPress.org, leído el 4 de septiembre y el 9 de octubre de 2026. https://wordpress.org/plugins/litespeed-cache/ y https://wordpress.org/plugins/w3-total-cache/
Wordfence 9.0.0 reserva a Google su única regla para rastreadores
Wordfence se instala con sus cinco límites de peticiones desactivados: todas las peticiones, páginas vistas por rastreadores, errores 404 de rastreadores, páginas vistas por humanos y errores 404 de humanos. El interruptor general, «Enable Rate Limiting and Advanced Blocking», en cambio, viene activado, de modo que cualquier límite entra en vigor en cuanto alguien escribe una cifra.
Para los rastreadores de los buscadores, Wordfence ofrece un único ajuste, «How should we treat Google’s crawlers». Por defecto exime de todos los límites a los rastreadores de Google verificados. El plugin los comprueba con los rangos de IP de Google y con una consulta inversa que debe terminar en googlebot.com o en otro nombre de host de Google, confirmada después en sentido directo. Baidu no dispone de nada equivalente, ni tampoco ningún otro buscador.
Escriba un número en «If a crawler’s page views exceed», dentro de las Rate Limiting Rules del cortafuegos, y Googlebot pasará de largo, mientras que a Baiduspider se le contará como a cualquier otro bot. Cuando supera el límite, recibe un 503, tanto si la acción se deja en ralentizar como si se cambia a bloquear. Wordfence deja constancia de la ralentización. Baidu, en cambio, solo recibe un error de servidor, y se repite el patrón descrito más arriba: el rastreador pasa el martes y el miércoles se queda fuera.
La solución evidente sería añadir Baiduspider a una lista blanca. La de Wordfence, «Allowlisted IP addresses that bypass all rules», solo admite direcciones y rangos de IP (el plugin no tiene ninguna lista blanca por agente de usuario), y Baidu, como ya se ha visto, no publica sus rangos.
Wordfence 9.0.0 trae sus cinco límites de peticiones en DISABLED. Su único ajuste para rastreadores, «How should we treat Google’s crawlers», tiene por defecto «Verified Google crawlers will not be rate-limited». Su lista blanca solo acepta direcciones y rangos de IP. Wordfence 9.0.2, la versión vigente, lo mantiene todo igual. Fuente: código fuente de Wordfence 9.0.0 (publicada el 10 de agosto de 2026), leído el 4 de septiembre y el 9 de octubre de 2026, y de la 9.0.2, leído el 9 de octubre de 2026. https://wordpress.org/plugins/wordfence/
Mantenga desactivados los límites de Wordfence para rastreadores, o fíjelos muy por encima de lo que envía un rastreo. Si necesita limitar a los rastreadores, hágalo en el CDN o en el WAF que protege el sitio, donde una regla puede ejecutar la comprobación por DNS inverso antes de empezar a contar.
La lista de bloqueo de Solid Security rechaza a 360 Search y a Shenma
Solid Security se distribuye con el identificador de plugin better-wp-security y, desde la versión 10.0.0 de mayo de 2026, lleva el nombre de Kadence Security. Su módulo Ban Users tiene un ajuste llamado «Default Ban List», desactivado en una instalación nueva. Su descripción lo presenta como un punto de partida.
Si lo activa, el plugin escribe la lista de bloqueo de HackRepair.com en la configuración del servidor: .htaccess en Apache y LiteSpeed, nginx.conf en nginx. Esa lista responde con un 403 a cualquier agente de usuario que contenga 360Spider o YisouSpider, además de una tercera cadena, EasouSpider. 360Spider rastrea para 360 Search (360搜索) y YisouSpider para Shenma Search (神马搜索).
Baiduspider no está en la lista.
Solid Security 10.0.3 trae «Default Ban List» con “default”: false. Cuando se activa, la lista de HackRepair.com se escribe en la configuración del servidor y devuelve un 403 a los agentes de usuario que coinciden con 360Spider, EasouSpider y YisouSpider. Kadence Security 10.0.5, la versión vigente, contiene la misma lista. Fuente: código fuente de Solid Security 10.0.3 (publicada el 27 de julio de 2026), leído el 4 de septiembre y el 9 de octubre de 2026, y de la 10.0.5, leído el 9 de octubre de 2026. https://wordpress.org/plugins/better-wp-security/
La regla se aloja en la configuración del servidor, así que WordPress nunca ve la petición y nada queda anotado en los registros del propio plugin. Un sitio en el que alguien la activó durante la puesta en marcha lleva rechazando a 360 Search y a Shenma desde entonces.
El agente de usuario del rastreador de Shenma Search es yisouspider. Fuente: plataforma para webmasters de Shenma Search (神马搜索), julio de 2014. https://zhanzhang.sm.cn/open/optimizaGuide
Desactive la Default Ban List; después, abra .htaccess o nginx.conf y compruebe que ha desaparecido el bloque que empieza por «# Start HackRepair.com Blacklist». Si quiere readmitir a 360 Search por su dirección IP, tenga en cuenta que sus reglas funcionan al revés que las de Baidu. 360 publica los rangos de IP de su rastreador y dice que la consulta inversa todavía no funciona con él, de modo que lo que pide es una lista blanca de IP.
El rastreador de 360 Search lleva 360Spider en su agente de usuario. 360 publica los rangos de IP de su rastreador en la misma página y afirma que la verificación por nslookup aún no está disponible. Fuente: 360 Search (360搜索), página de ayuda 360蜘蛛IP, febrero de 2026. https://www.so.com/help/spider_ip.html
Haga que Baidu le cuente qué recibió
El diagnóstico de rastreo (抓取诊断) de la Baidu Search Resource Platform (百度搜索资源平台) recupera una URL haciéndose pasar por Baiduspider y le muestra la respuesta. Agente de escritorio o móvil, a su elección. Devuelve los primeros 200 KB del cuerpo, suficiente para revelar un intersticial o una página de error.
Nosotros recurrimos a él antes de tocar nada más, porque termina con las discusiones. Ejecútelo sobre la portada, sobre el archivo de verificación y sobre tres páginas profundas. Las reglas de borde suelen estar acotadas por ruta, y la portada suele ser la única ruta que alguien eximió.
Cada sitio dispone de 70 recuperaciones a la semana, así que la herramienta no sirve como prueba de carga. Lea, además, el cuerpo que devuelve: un 200 no dice nada de su contenido.
El diagnóstico de rastreo permite 70 recuperaciones a la semana por sitio y muestra los primeros 200 KB del contenido que ve Baiduspider. Fuente: Baidu Search Resource Platform (百度搜索资源平台), página de la herramienta de diagnóstico de rastreo, consultada el 9 de octubre de 2026. https://ziyuan.baidu.com/crawltools/index
El alojamiento en el extranjero empeora todos estos casos
Alojar fuera de China continental no bloquea nada por sí mismo. Añade latencia y pérdida de paquetes por encima de lo que ya estén haciendo sus reglas.
Añada un viaje de ida y vuelta más por un desafío sobre una conexión que va justa y dejará de ir justa. Un tiempo de espera agotado de entrada y salida se parece exactamente a esto visto desde fuera: la página carga rápido desde Europa mientras Baidu registra una conexión que se dio por vencida. El alojamiento continental elimina esa variable, a cambio de un registro ICP (ICP备案).
En qué orden conviene cambiar las cosas
Empiece por sus registros. Filtre el borde por los agentes de usuario de Baiduspider durante los últimos 30 días. Cero peticiones significa que el rastreador no está llegando hasta usted en absoluto. Si hay peticiones, la pregunta pasa a ser qué devolvió usted.
Retire después los instrumentos contundentes por orden. Las reglas geográficas que afectan a China salen primero, o se estrechan hasta las rutas que realmente las necesitan. Las excepciones de gestión de bots para un Baiduspider autenticado vienen después, y luego las excepciones sobre el conjunto de reglas gestionado, una vez que sepa qué regla se disparó. Los límites de peticiones al final, porque son el fallo más difícil de atribuir.
En un sitio WordPress, el siguiente paso es el origen. Desactive la Default Ban List de Solid Security si está activada y compruebe si alguien ha fijado un límite para rastreadores en Wordfence.
Revise robots.txt ya que está. El comprobador de Baidu limita el archivo a 48 KB, y un disallow perdido copiado de preproducción ha costado más lanzamientos en China que cualquier regla de cortafuegos.
La herramienta de robots de Baidu comprueba hasta 48 KB de un archivo robots.txt. Fuente: Baidu Search Resource Platform (百度搜索资源平台), página de la herramienta de robots, consultada el 9 de octubre de 2026. https://ziyuan.baidu.com/robots/index
Cuando las reglas estén retiradas, vuelva a ejecutar el diagnóstico de rastreo empezando por el archivo de verificación, la URL que está reteniendo todo lo demás. La verificación se resuelve entre al instante y 24 horas en cuanto el rastreador puede leerla. El volumen de índice es más lento: cero durante días o semanas incluso cuando todo está correcto, y una indexación inicial que suele llevar de dos a cuatro semanas. Cambie una cosa cada vez, o el siguiente cero no le dirá nada.
Vuelva a ejecutar el diagnóstico de rastreo después de cualquier actualización del WAF o del CDN, porque los valores por defecto del borde cambian según su propio calendario.
¿Le echamos una mano?
ChinaWebFoundry lleva proyectos web en China de principio a fin. Si todo esto le parece más de lo que quiere afrontar solo, escríbanos.
Hablemos