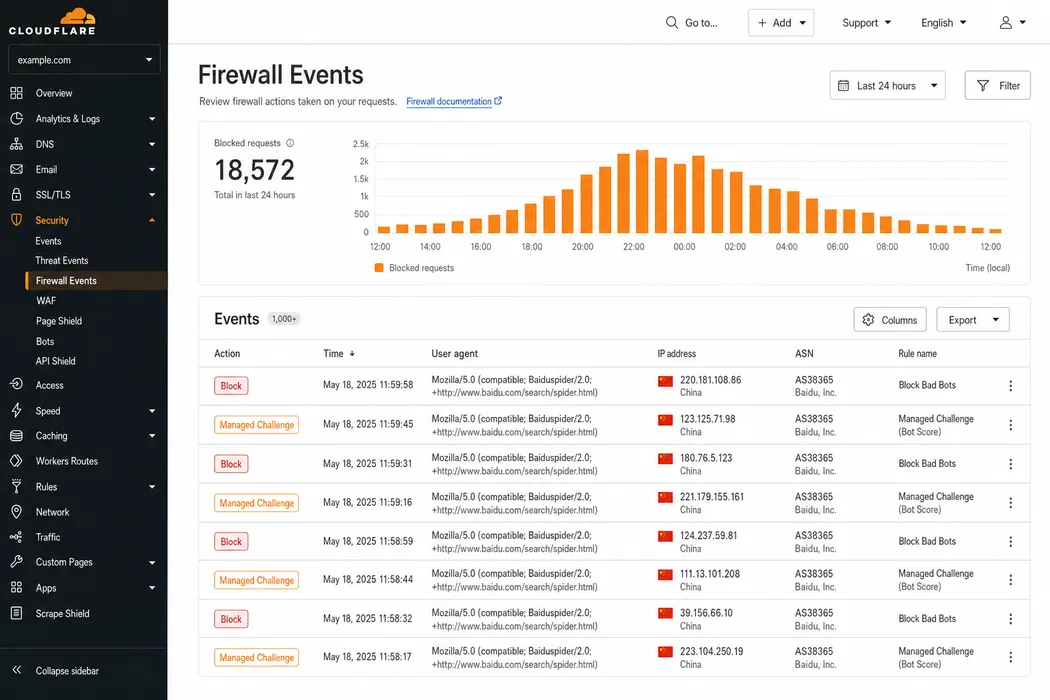
Nichts in einem üblichen Monitoring-Stack achtet darauf. Verfügbarkeitsprüfungen laufen aus Frankfurt und Virginia, und Real-User-Monitoring sieht nur Menschen, die bereits eine Seite bekommen haben. Währenddessen wird der eine Besucher, auf den es ankommt, an der Edge abgewiesen, und sichtbar wird das allein auf einem Dashboard, das niemand geöffnet hat.
Wir sehen das häufiger als jede andere technische Ursache für einen festgefahrenen China-Start, weit vor allem, was in der WordPress-Umsetzung selbst passiert, und fast immer steckt eine Einstellung dahinter, an die sich niemand erinnert.
Warum Ihre Standardregeln Baidus Crawler erwischen
Baiduspider erreicht Ihren Origin über Netze aus Festlandchina. Reverse DNS auf legitime Crawler-Adressen löst zu *.baidu.com oder *.baidu.jp auf, wobei die Abrufe überwiegend aus den Festlandbereichen kommen.
Und nun überlegen Sie, was eine übliche Sicherheitskonfiguration mit diesen Bereichen macht. Meist gibt es eine Geo-Regel, die China herausfordert oder blockiert, während eines Vorfalls hinzugefügt und nie wieder angefasst, dazu eine Bot-Management-Einstellung, die unbekannte automatisierte Clients als verdächtig bewertet. Darunter liegt ein verwaltetes Regelwerk, das auf westlichem Traffic kalibriert ist. Keine dieser Regeln wurde mit Blick auf einen chinesischen Suchcrawler geschrieben. Baiduspider sieht aus wie automatisierter Traffic aus einer Region, der Sie das Misstrauen ausgesprochen haben, und bekommt entsprechend das, was Sie dafür konfiguriert haben.
Nichts davon erzeugt einen Alarm. Ein blockierter Crawler schreibt kein Ticket. Er versucht es erneut, bekommt dieselbe Antwort und kommt seltener wieder.
Baidu hielt im September 2026 laut Statcounter über alle Plattformen hinweg 46,65 % des Suchmaschinenmarkts in China, auf Mobilgeräten 60,15 %. Quelle: Statcounter Global Stats, September 2026. https://gs.statcounter.com/search-engine-market-share/all/china und https://gs.statcounter.com/search-engine-market-share/mobile/china
Dieser Markt liegt auf der anderen Seite der Regel.
Der Fall, der nie gelöst wurde
Es gibt einen Thread in der Cloudflare-Community, den man einmal gelesen haben sollte. Ein Websitebetreiber hatte die Baidu-Verifizierungsdatei baidu_verify_codeva-CODE.html ins Wurzelverzeichnis gelegt. Sie war öffentlich erreichbar, und jeder außerhalb Chinas konnte sie mit Status 200 abrufen. Baidus Prüfung meldete eine E/A-Zeitüberschreitung. Der Thread endete ohne Lösung.
Dieser Fall belegt nicht, dass Cloudflare Baidu grundsätzlich blockiert. Er zeigt etwas Engeres: Eine von Ihrem Schreibtisch aus erreichbare Datei beweist nichts darüber, ob Baidu sie erreichen kann, und beide Befunde können wochenlang auseinanderlaufen, während alle auf eine URL starren, die funktioniert.
Baidus Dateiverifizierung ist eng gefasst. Die Datei liegt im Wurzelverzeichnis und antwortet mit 200, ohne Weiterleitung und ohne Authentifizierung. Die Tag-Methode ist nicht nachsichtiger, denn das Meta-Tag muss in dem HTML stehen, das der Server ausliefert. Eine Zwischenseite bricht beides.
Ein 403 ist das gute Ergebnis
Wenn die Edge Baiduspider rundheraus abweist, bekommen Sie einen 403, und das ist das Ergebnis, auf das man hoffen sollte. Eine Ablehnung ist eine Tatsache, die beide Seiten sehen.
Teuer wird die Challenge. Eine JavaScript-Zwischenseite liefert einen 200, Ihre Zugriffsprotokolle verzeichnen eine ausgelieferte Anfrage, und der Crawler bekommt eine Seite voller Skript statt Ihrer Inhalte. Sämtliche Dashboards melden Erfolg, und auf Baidus Seite steht ein Abruf ohne Inhalt.
Rate Limiting ist das dritte Muster und beim Debuggen das schlimmste. Der Crawler kommt am Dienstag durch und am Mittwoch nicht, und keine benennbare Regel erklärt, warum.
Reverse DNS ist die einzige Prüfung, die hält
Den User-Agent freizugeben ist der richtige Anfang und das falsche Ende. Die legitimen Zeichenketten sind Baiduspider/2.0 und Baiduspider-render/2.0, mobile Varianten führen Android oder Mobile. Die render-Variante wird gern übersehen. Sie holt, was eine Seite zum Rendern braucht, sodass eine Regel, die Baiduspider/2.0 erlaubt und den Rest drosselt, den Crawler hereinlässt und dann aushungert.
Ein User-Agent ist ein Request-Header, und ein Request-Header ist eine Zeichenkette, die jeder tippen kann. Wer allein darauf freigibt, hat seine WAF für jeden geöffnet, der einen Blogbeitrag gelesen hat.
Die Prüfung, die hält, ist ein vorwärts bestätigter Reverse-Lookup. Nehmen Sie die Client-IP, lösen Sie den PTR-Eintrag mit host oder dig auf, prüfen Sie, ob der Hostname auf baidu.com oder baidu.jp endet, und lösen Sie diesen Hostnamen anschließend vorwärts auf, um zu sehen, ob dieselbe Adresse zurückkommt. Ein PTR-Eintrag allein beweist nichts, denn er wird von demjenigen gesetzt, der den Adressblock kontrolliert.
Bauen Sie die Regel in dieser Reihenfolge: User-Agent abgleichen, per Reverse DNS bestätigen, dann freigeben. Manche Edge-Plattformen erledigen das für bekannte Crawler von selbst. Wo Ihre es nicht tut, genügt ein kurzes Worker-Skript.
Baidu beschreibt in seiner eigenen Anleitung genau diese beiden Abfragen und warnt zusätzlich vor IP-Listen.
Ein echter Baiduspider-Hostname endet auf .baidu.com oder .baidu.jp, alles andere ist eine Fälschung. Ein Forward-Lookup dieses Hostnamens muss die ursprüngliche IP zurückliefern. Baidu erklärt, die IP-Bereiche seines Crawlers nicht veröffentlichen zu können, weil sie sich laufend ändern. Quelle: Baidu Search Resource Platform (百度搜索资源平台), Februar 2022. https://ziyuan.baidu.com/college/articleinfo?id=3378
Chinesische SEO-Blogs veröffentlichen weiterhin Listen mit IP-Bereichen von Baiduspider. Wer daraus eine Whitelist baut, friert Adressen ein, die sich nach Baidus eigener Aussage ändern werden. Verifizieren Sie den Crawler jedes Mal per Reverse DNS, niemals anhand des User-Agents.
Was vier WordPress-Plugins mit chinesischen Crawlern machen
Hat die Edge eine Anfrage durchgelassen, greift auf einer WordPress-Website ein zweites Regelwerk. Es steckt in den Sicherheits- und Cache-Plugins, und die einzige Crawler-Ausnahme, die wir darin gefunden haben, gilt Google.
Den Quellcode von vier Plugins haben wir am 4. September 2026 gelesen und am 9. Oktober 2026 an den aktuellen Versionen ein zweites Mal geprüft. Bei zwei von ihnen genügt eine einzige geänderte Einstellung, und chinesische Crawler werden abgewiesen. In LiteSpeed Cache und W3 Total Cache steckt nichts dergleichen.
| Plugin | Gelesene Version | Auslieferungszustand | Was chinesische Crawler abweisen kann |
|---|---|---|---|
| Wordfence | 9.0.0, unverändert in 9.0.2 | Alle fünf Rate Limits aus. Eine einzige Crawler-Regel, nur für Google | Eine Zahl im Feld „If a crawler’s page views exceed“ |
| Solid Security, heute Kadence Security | 10.0.3, unverändert in 10.0.5 | „Default Ban List“ aus | Eingeschaltet schreibt sie einen 403 für 360Spider, EasouSpider und YisouSpider in die Serverkonfiguration |
| LiteSpeed Cache | 7.9.1 | „Do Not Cache User Agents“ leer | Nichts im Code gefunden |
| W3 Total Cache | 2.10.6, unverändert in 2.10.7 | Listen abgelehnter User-Agents leer | Nichts im Code gefunden |
Damit sind die Cache-Plugins aus dem Spiel. Ihre User-Agent-Listen regeln nur, welche Besucher am Cache vorbeigeleitet werden, und in beiden Plugins sind sie ab Werk leer. Bekommt Baiduspider auf einer Website mit einem der beiden einen 403, liegt die Ursache anderswo im Stack.
LiteSpeed Cache 7.9.1 liefert „Do Not Cache User Agents“ leer aus. W3 Total Cache 2.10.6 liefert seine Listen abgelehnter User-Agents für Page Cache, Minify und CDN leer aus, 2.10.7 ebenso. In keinem der beiden Plugins findet sich im Code eine Regel, die Baiduspider nennt. Quelle: Quellcode von LiteSpeed Cache 7.9.1 und W3 Total Cache 2.10.6, WordPress.org, gelesen am 4. September und 9. Oktober 2026. https://wordpress.org/plugins/litespeed-cache/ und https://wordpress.org/plugins/w3-total-cache/
Wordfence 9.0.0 kennt eine Crawler-Regel, und die gilt nur Google
Ab Werk sind in Wordfence alle fünf Rate Limits ausgeschaltet: alle Anfragen, Seitenaufrufe von Crawlern, 404-Fehler von Crawlern, Seitenaufrufe von Menschen und 404-Fehler von Menschen. Der Hauptschalter „Enable Rate Limiting and Advanced Blocking“ ist dagegen eingeschaltet, sodass ein Limit greift, sobald jemand eine Zahl einträgt.
Wordfence hat genau eine Einstellung für Suchmaschinen-Crawler: „How should we treat Google’s crawlers“. Standardmäßig nimmt sie verifizierte Google-Crawler von jedem Rate Limit aus. Das Plugin prüft sie anhand der IP-Bereiche von Google und eines Reverse-Lookups, der auf googlebot.com oder einem anderen Google-Hostnamen enden und per Forward-Lookup bestätigt werden muss. Für Baidu gibt es nichts Vergleichbares, ebenso wenig für irgendeine andere Suchmaschine.
Tragen Sie unter den Rate Limiting Rules der Firewall eine Zahl bei „If a crawler’s page views exceed“ ein, und Googlebot zieht daran vorbei, während Baiduspider wie jeder andere Bot gezählt wird. Ist das Limit überschritten, erhält Baiduspider einen 503, gleich ob die Aktion auf Drosseln steht oder auf Blockieren umgestellt wurde. Wordfence protokolliert die Drosselung. Baidu sieht nur einen Serverfehler, und es entsteht genau das oben beschriebene Muster: am Dienstag durch, am Mittwoch abgewiesen.
Naheliegend wäre es, Baiduspider auf die Whitelist zu setzen. Doch die Whitelist von Wordfence, „Allowlisted IP addresses that bypass all rules“, akzeptiert nur IP-Adressen und -Bereiche (eine User-Agent-Whitelist hat das Plugin überhaupt nicht), und Baidu veröffentlicht seine Bereiche, wie oben zitiert, nicht.
Wordfence 9.0.0 liefert seine fünf Rate Limits auf DISABLED aus. Seine einzige Crawler-Einstellung, „How should we treat Google’s crawlers“, steht standardmäßig auf „Verified Google crawlers will not be rate-limited“. Seine Whitelist akzeptiert nur IP-Adressen und -Bereiche. Wordfence 9.0.2, die aktuelle Version, ist unverändert. Quelle: Quellcode von Wordfence 9.0.0 (veröffentlicht am 10. August 2026), gelesen am 4. September und 9. Oktober 2026, und von 9.0.2, gelesen am 9. Oktober 2026. https://wordpress.org/plugins/wordfence/
Lassen Sie die Crawler-Limits von Wordfence ausgeschaltet, oder setzen Sie sie so hoch an, dass kein Crawl sie erreicht. Wer Crawler drosseln muss, tut das am besten am CDN oder an der WAF vor der Website, wo eine Regel die Reverse-DNS-Prüfung ausführen kann, bevor sie zu zählen beginnt.
Die Sperrliste von Solid Security weist 360 Search und Shenma ab
Solid Security wird unter dem Plugin-Slug better-wp-security ausgeliefert und trägt seit Version 10.0.0 vom Mai 2026 den Namen Kadence Security. Sein Modul Ban Users hat eine Einstellung namens „Default Ban List“, die nach einer Neuinstallation ausgeschaltet ist. Ihre Beschreibung nennt sie einen Ausgangspunkt.
Schalten Sie sie ein, schreibt das Plugin die Sperrliste von HackRepair.com in Ihre Serverkonfiguration: .htaccess unter Apache und LiteSpeed, nginx.conf unter nginx. Diese Liste antwortet mit 403 auf jeden User-Agent, der 360Spider oder YisouSpider enthält, dazu auf eine dritte Zeichenkette, EasouSpider. 360Spider crawlt für 360 Search (360搜索), YisouSpider für Shenma Search (神马搜索).
Baiduspider steht nicht auf der Liste.
Solid Security 10.0.3 liefert „Default Ban List“ mit “default”: false aus. Ist sie eingeschaltet, wird die Liste von HackRepair.com in die Serverkonfiguration geschrieben und gibt User-Agents, die auf 360Spider, EasouSpider und YisouSpider passen, einen 403 zurück. Kadence Security 10.0.5, die aktuelle Version, enthält dieselbe Liste. Quelle: Quellcode von Solid Security 10.0.3 (veröffentlicht am 27. Juli 2026), gelesen am 4. September und 9. Oktober 2026, und von 10.0.5, gelesen am 9. Oktober 2026. https://wordpress.org/plugins/better-wp-security/
Die Regel sitzt in der Serverkonfiguration, deshalb sieht WordPress die Anfrage nie, und in den Protokollen des Plugins taucht nichts davon auf. Eine Website, auf der jemand sie bei der Einrichtung eingeschaltet hat, weist 360 Search und Shenma seitdem ab.
Der User-Agent des Crawlers von Shenma Search lautet yisouspider. Quelle: Webmaster-Plattform von Shenma Search (神马搜索), Juli 2014. https://zhanzhang.sm.cn/open/optimizaGuide
Schalten Sie die Default Ban List aus, öffnen Sie dann .htaccess oder nginx.conf und prüfen Sie, ob der Block, der mit „# Start HackRepair.com Blacklist“ beginnt, verschwunden ist. Wer 360 Search über seine Adressen wieder zulassen will, muss umdenken: Hier laufen die Regeln genau andersherum als bei Baidu. 360 veröffentlicht die IP-Bereiche seines Crawlers und erklärt, dass der Reverse-Lookup für ihn noch nicht funktioniert; gefragt ist also eine IP-Whitelist.
Der Crawler von 360 Search trägt 360Spider in seinem User-Agent. 360 veröffentlicht die IP-Bereiche seines Crawlers auf derselben Seite und erklärt, dass die Prüfung per nslookup noch nicht unterstützt wird. Quelle: 360 Search (360搜索), Hilfeseite 360蜘蛛IP, Februar 2026. https://www.so.com/help/spider_ip.html
Lassen Sie Baidu erzählen, was es bekommen hat
Die Crawl-Diagnose (抓取诊断) in der Baidu Search Resource Platform (百度搜索资源平台) ruft eine URL als Baiduspider ab und zeigt Ihnen die Antwort. Desktop- oder Mobil-Agent, ganz nach Wahl. Sie liefert die ersten 200 KB des Bodys, genug, um eine Zwischenseite oder eine Fehlerseite sichtbar zu machen.
Wir greifen dazu, bevor wir irgendetwas anderes anfassen, weil es Diskussionen beendet. Lassen Sie sie über die Startseite laufen, über die Verifizierungsdatei und über drei tiefer liegende Seiten. Edge-Regeln sind oft pfadgebunden, und die Startseite ist meist der eine Pfad, den jemand ausgenommen hat.
Jede Website hat ein Kontingent von 70 Abrufen pro Woche; für einen Lasttest taugt das Werkzeug also nicht. Lesen Sie außerdem den zurückgegebenen Body: Ein 200 verrät nichts über dessen Inhalt.
Die Crawl-Diagnose erlaubt 70 Abrufe pro Woche und Website und zeigt die ersten 200 KB der Inhalte, die Baiduspider sieht. Quelle: Baidu Search Resource Platform (百度搜索资源平台), Seite des Crawl-Diagnose-Werkzeugs, abgerufen am 9. Oktober 2026. https://ziyuan.baidu.com/crawltools/index
Hosting im Ausland verschärft jeden dieser Fälle
Hosting außerhalb Festlandchinas blockiert für sich genommen nichts. Es legt Latenz und Paketverlust auf das, was Ihre Regeln ohnehin schon anrichten.
Geben Sie einer knappen Verbindung einen zusätzlichen Roundtrip für eine Challenge, und sie ist nicht mehr knapp, sondern weg. Eine E/A-Zeitüberschreitung sieht von außen genau so aus: Die Seite lädt aus Europa schnell, während Baidu eine Verbindung protokolliert, die aufgegeben hat. Hosting auf dem Festland beseitigt diese Variable, zum Preis einer ICP-Registrierung (ICP备案).
In welcher Reihenfolge man etwas ändert
Fangen Sie bei Ihren Protokollen an. Filtern Sie die Edge über die vergangenen 30 Tage nach den Baiduspider-User-Agents. Null Anfragen heißt, der Crawler erreicht Sie überhaupt nicht. Gibt es Anfragen, lautet die Frage, was Sie zurückgeschickt haben.
Nehmen Sie dann die groben Instrumente der Reihe nach heraus. Geo-Regeln, die China betreffen, zuerst, oder verengen Sie sie auf die Pfade, die sie wirklich brauchen. Danach Ausnahmen im Bot-Management für bestätigten Baiduspider, dann Ausnahmen im verwalteten Regelwerk, sobald Sie wissen, welche Regel ausgelöst hat. Rate Limits zuletzt, weil sie sich am schwersten zuordnen lassen.
Bei WordPress ist danach der Origin an der Reihe. Schalten Sie die Default Ban List von Solid Security aus, falls sie an ist, und prüfen Sie, ob jemand in Wordfence ein Crawler-Limit gesetzt hat.
Prüfen Sie bei der Gelegenheit die robots.txt. Baidus Prüfwerkzeug deckelt die Datei bei 48 KB, und ein aus dem Staging kopiertes verirrtes Disallow hat mehr China-Starts gekostet als jede Firewall-Regel.
Baidus Robots-Werkzeug prüft bis zu 48 KB einer robots.txt-Datei. Quelle: Baidu Search Resource Platform (百度搜索资源平台), Seite des Robots-Werkzeugs, abgerufen am 9. Oktober 2026. https://ziyuan.baidu.com/robots/index
Sind die Regeln entfernt, wiederholen Sie die Crawl-Diagnose, beginnend mit der Verifizierungsdatei, der URL, an der alles andere hängt. Die Verifizierung greift zwischen sofort und 24 Stunden, sobald der Crawler sie lesen kann. Das Indexvolumen ist träger: null über Tage bis Wochen, selbst wenn alles stimmt, wobei die erste Indexierung üblicherweise zwei bis vier Wochen dauert. Ändern Sie eine Sache nach der anderen, sonst sagt Ihnen die nächste Null gar nichts.
Wiederholen Sie die Crawl-Diagnose nach jedem WAF- oder CDN-Upgrade, denn Edge-Voreinstellungen ändern sich nach ihrem eigenen Zeitplan.
Brauchen Sie dabei Hilfe?
ChinaWebFoundry betreut Web-Projekte in China von A bis Z. Wenn Ihnen das alles nach mehr aussieht, als Sie allein angehen möchten, melden Sie sich.
Sprechen Sie uns an